Semantic View技术解析(三):指标、关系与过滤规则如何约束查询结果
本文发表于: &{ new Date(1789920000000).toLocaleDateString() }
前两篇用个人渔具消费数据说明了 Semantic View 如何定义表、关系、维度和指标。在这个例子中,t_item 的一行代表一次购买,real_amount 表示实际消费金额,商品类型和品牌分别来自 t_item_type 与 t_item_brand。
当用户询问“2024 年每个品牌实际花了多少钱”时,系统需要确定金额字段、品牌关系和时间范围。Semantic View 可以提供已经确认的指标与关系定义,减少每次生成 SQL 时重新判断字段和 Join 路径的情况。但查询结果是否正确,还取决于模型是否理解了问题、定义是否符合业务实际,以及底层数据是否完整。
1. 订单语义模型中的维度、指标与关系
以一组订单样例来展开,orders 记录订单编号、客户编号、状态、金额和日期,customer 保存客户名称。
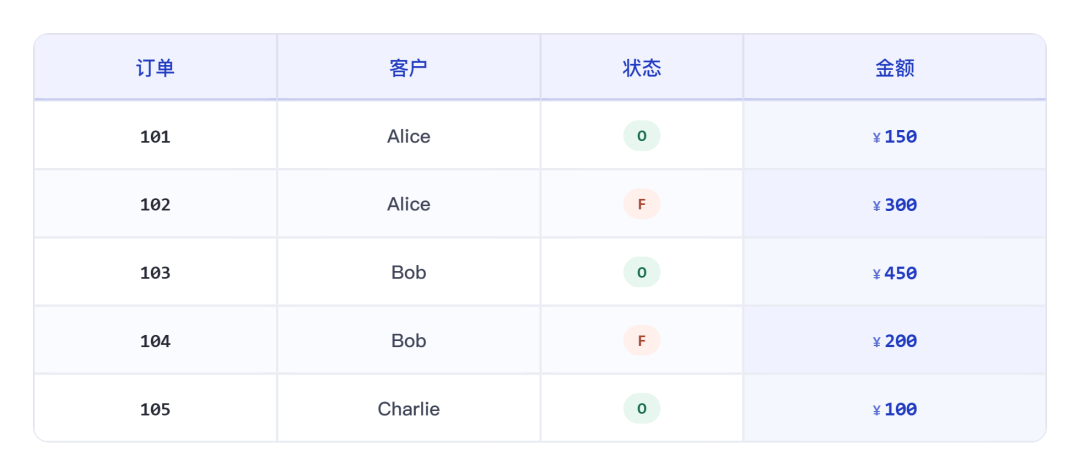
假设用户询问“每位客户已完成订单的金额”。生成查询前,需要确认三项业务定义:
- 状态 F 表示已完成订单;
- 订单金额取自 o_totalprice;
- 订单通过 o_custkey 关联客户。
这些信息可以进入 Semantic View 的维度、指标、关系和注释:
CREATE SEMANTIC VIEW sales_db.order_metrics
  TABLES (
    orders AS sales_db.orders PRIMARY KEY (o_orderkey),
    customer AS sales_db.customer PRIMARY KEY (c_custkey)
  )
  RELATIONSHIPS (
    ord_to_cust AS orders (o_custkey) REFERENCES customer
  )
  DIMENSIONS (
    orders.order_status AS o_orderstatus
      COMMENT = 'Order status. F means fulfilled and O means open.'
      SAMPLE_VALUES = ('F', 'O'),
    customer.cust_name AS c_name
      COMMENT = 'Full name of the customer'
  )
  METRICS (
    orders.total_price AS SUM(o_totalprice)
      COMMENT = 'Total monetary value of orders'
  );
对应的语义查询为:
SELECT *
FROM SEMANTIC_VIEW(
    sales_db.order_metrics
    METRICS orders.total_price
    DIMENSIONS customer.cust_name
    WHERE orders.order_status = 'F'
)
ORDER BY cust_name;
这里由模型或调用方选择“客户名称”和“订单总额”,并把“已完成”映射为状态 F。关系和指标表达式由 Semantic View 提供,查询展开时不需要再次生成客户关联条件和金额聚合公式。
过滤条件是否写入 Semantic View,需要根据适用范围决定。如果该视图下的所有分析都只统计已完成订单,可以配置视图级全局过滤:
FILTER o_orderstatus = 'F'全局 FILTER 会应用于每次查询,并与查询中的 WHERE 条件通过 AND 合并。如果“已完成订单”只适用于当前问题,应把它保留在本次查询中。适用范围不清楚的条件不宜直接设为全局规则。
2. SQL 展开:核对指标、关联与过滤条件
EXPLAIN INLINE 用于查看语义查询展开后的等价 SQL。根据展开规则,上述查询会形成以下结构。具体标识符和格式以目标版本的实际输出为准。
SELECT `order_metrics`.`cust_name`,
       `order_metrics`.`total_price`
FROM (
  SELECT `customer`.`c_name` AS `cust_name`,
         SUM(`orders`.`o_totalprice`) AS `total_price`
  FROM `sales_db`.`orders` AS `orders`
  LEFT JOIN `sales_db`.`customer` AS `customer`
    ON `orders`.`o_custkey` = `customer`.`c_custkey`
  WHERE `orders`.`o_orderstatus` = 'F'
  GROUP BY 1
) `order_metrics`
ORDER BY cust_name;
人工核对样例数据,已完成订单共有两笔:Alice 为 300,Bob 为 200,合计 500。展开后的 SQL 可以继续核对四项内容:是否使用 o_totalprice、是否筛选状态 F、是否通过 o_custkey 关联客户,以及是否按客户聚合。
这一步检查的是语义定义如何进入实际查询。展开结果与预期不一致时,可以继续判断问题来自语义元素选择、Semantic View 定义,还是查询条件本身。
3. 粒度问题:订单与明细关联中的重复计算
同一组样例还包含 lineitem 表。一笔订单可以对应多条商品明细,其中订单 101 有两条明细,其余订单各有一条。五笔订单的金额合计为 1200。如果在商品明细粒度上直接汇总订单金额,订单 101 的 150 会被计算两次,结果变为 1350。
SELECT SUM(o.o_totalprice)
FROM sales_db.lineitem l
JOIN sales_db.orders o
  ON l.l_orderkey = o.o_orderkey;
PRIMARY KEY、UNIQUE 和 RELATIONSHIPS 可以描述表的粒度与关联方向,但这些内容属于元数据声明,不会修改底表,也不会自动清理重复数据。EXPLAIN SNOWFLAKE 可以检查查询的根表、唯一键依据和 Join 方向:
EXPLAIN SNOWFLAKE
SELECT SUM(o.o_totalprice)
FROM sales_db.lineitem l
JOIN sales_db.orders o
  ON l.l_orderkey = o.o_orderkey;
这条关系可以形成有效的雪花结构,因为每条明细指向一笔唯一订单。但查询的根表是lineitem,聚合前的关联结果仍以商品明细为粒度,因此同一笔订单的金额可能出现多次。直接对这些行汇总订单金额,就会产生重复计算。雪花结构有效,说明关联没有破坏根表的行粒度,不能证明在该粒度上汇总订单级金额符合业务口径。
遇到这种查询,需要回到指标所属的粒度处理。只统计订单总额时,应直接在 orders 粒度计算;必须同时使用商品明细时,可以先按订单聚合明细,再与订单指标关联,或者重新设计指标与查询路径。Semantic View 提供粒度和关系信息,具体建模需与指标的业务含义一致。
4. 查询准确性涉及的四个环节
前面的订单案例得到 Alice 300、Bob 200,并不只因为 SQL 可以执行。这个结果同时依赖用户意图、语义定义、查询展开和底层数据。其中一个环节出现偏差,都可能得到另一组数字。
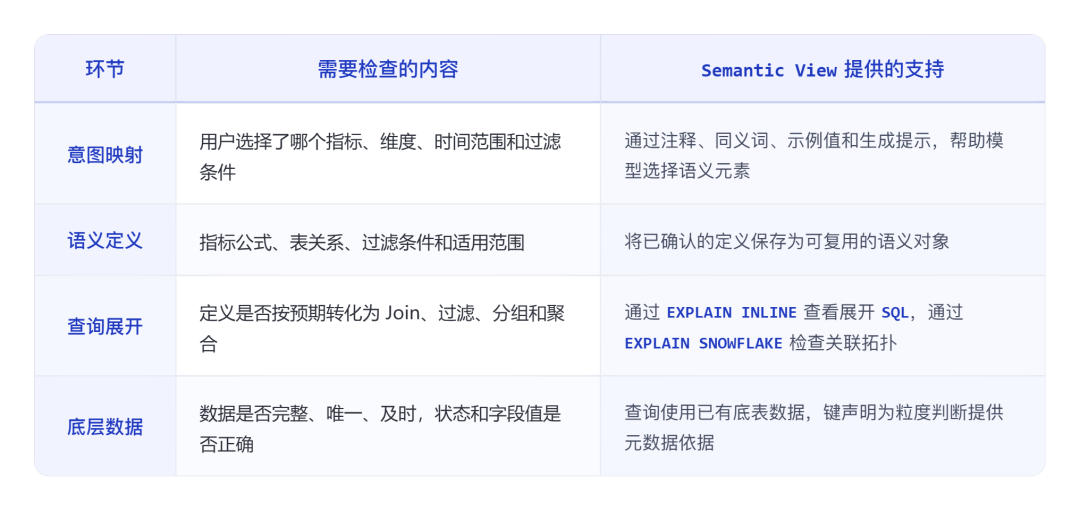
Semantic View 主要作用于语义定义和查询展开两个环节,同时为模型选择语义元素和检查关联粒度提供信息。它可以减少临时生成 SQL 时遗漏公式、Join 或过滤条件的情况,但最终结果仍受意图映射、定义质量和底层数据影响。
排查结果偏差时,可以沿着这四个环节逐层检查:先确认用户问题映射到了哪些语义元素,再检查 Semantic View 定义和展开 SQL,随后核对聚合粒度,最后检查底层数据。这样可以把问题定位到具体环节,避免把不同原因都归结为“模型不准”。
5. Semantic View 之外:审计、权限与数据质量
EXPLAIN INLINE 展示语义查询展开后的 SQL,可以检查实际使用的指标表达式、关联关系和过滤条件。它不记录查询由谁发起、在什么时间执行,也不包含完整的运行历史。查询审计仍需依赖数据库日志和审计机制;物理执行计划、资源消耗和运行状态也需要通过相应的数据库能力查看。
Semantic View 中的 fact 或 metric 可以标记为 PRIVATE,使其不出现在语义查询和 AI 建议中,同时继续用于内部计算。这项设置控制语义元素的可见性。数据库对象权限、行列访问控制以及 Agent 能否直接访问底表,需要通过数据库授权和 Agent 访问配置管理。
PRIMARY KEY、UNIQUE 和关系信息为查询展开与粒度检查提供元数据依据,但不会验证或修复底表中的重复记录。键声明与实际数据不一致时,查询结果仍可能出现偏差。数据缺失、状态标记错误、重复记录和历史数据更新等问题,需要由数据质量检查和数据治理流程处理。
Context 用于补充活动背景、业务缩写和结果解释。凡是会改变计算结果的信息,例如有效订单状态、赠品是否计入销售额、财务月份从哪一天开始,都应在业务确认后进入指标、维度、过滤条件或查询参数。只有进入查询定义的规则,才会实际参与计算。
语义定义后的收益:减少重复开发、对账
没有统一语义定义时,不同分析师、Agent 和 BI 报表需要分别选择金额字段、编写关联条件、添加状态过滤并确认聚合粒度。即使面对同一个业务问题,各处 SQL 也可能采用不同的实现。出现数字差异后,团队还需要逐条比较指标公式、Join 和过滤条件。
在 Semantic View 中,后续查询可以直接复用这些内容。新增分析主要处理指标、维度和查询条件的选择,已经定义的计算公式和关联路径不需要在每个 Agent 或报表中重新编写。业务口径发生变化时,也可以集中检查相关语义定义及其查询影响。
结果出现偏差时,排查可以沿着一条明确的路径进行:
先确认用户问题是否映射到正确的指标和维度,再检查 Semantic View 中的公式、关系与过滤条件,随后查看展开 SQL 和聚合粒度,最后核对底层数据。
这种分层方式减少了重复定义、重复开发和逐条对账,也让问题能够归到意图映射、语义定义、查询展开或数据质量中的具体环节。
Semantic View 将已经确认、能够形式化的业务规则带入查询执行过程。它减少了临时生成 SQL 时的口径遗漏与实现差异,也为结果核验提供了可以检查的 SQL 和粒度信息。最终结果取决于意图理解、业务定义和数据质量,但当这些环节被区分并能够逐层检查时,AI 问数才具备进入实际业务流程所需的工程基础。