


自动化数据管道和工作流将如何改变大数据架构?
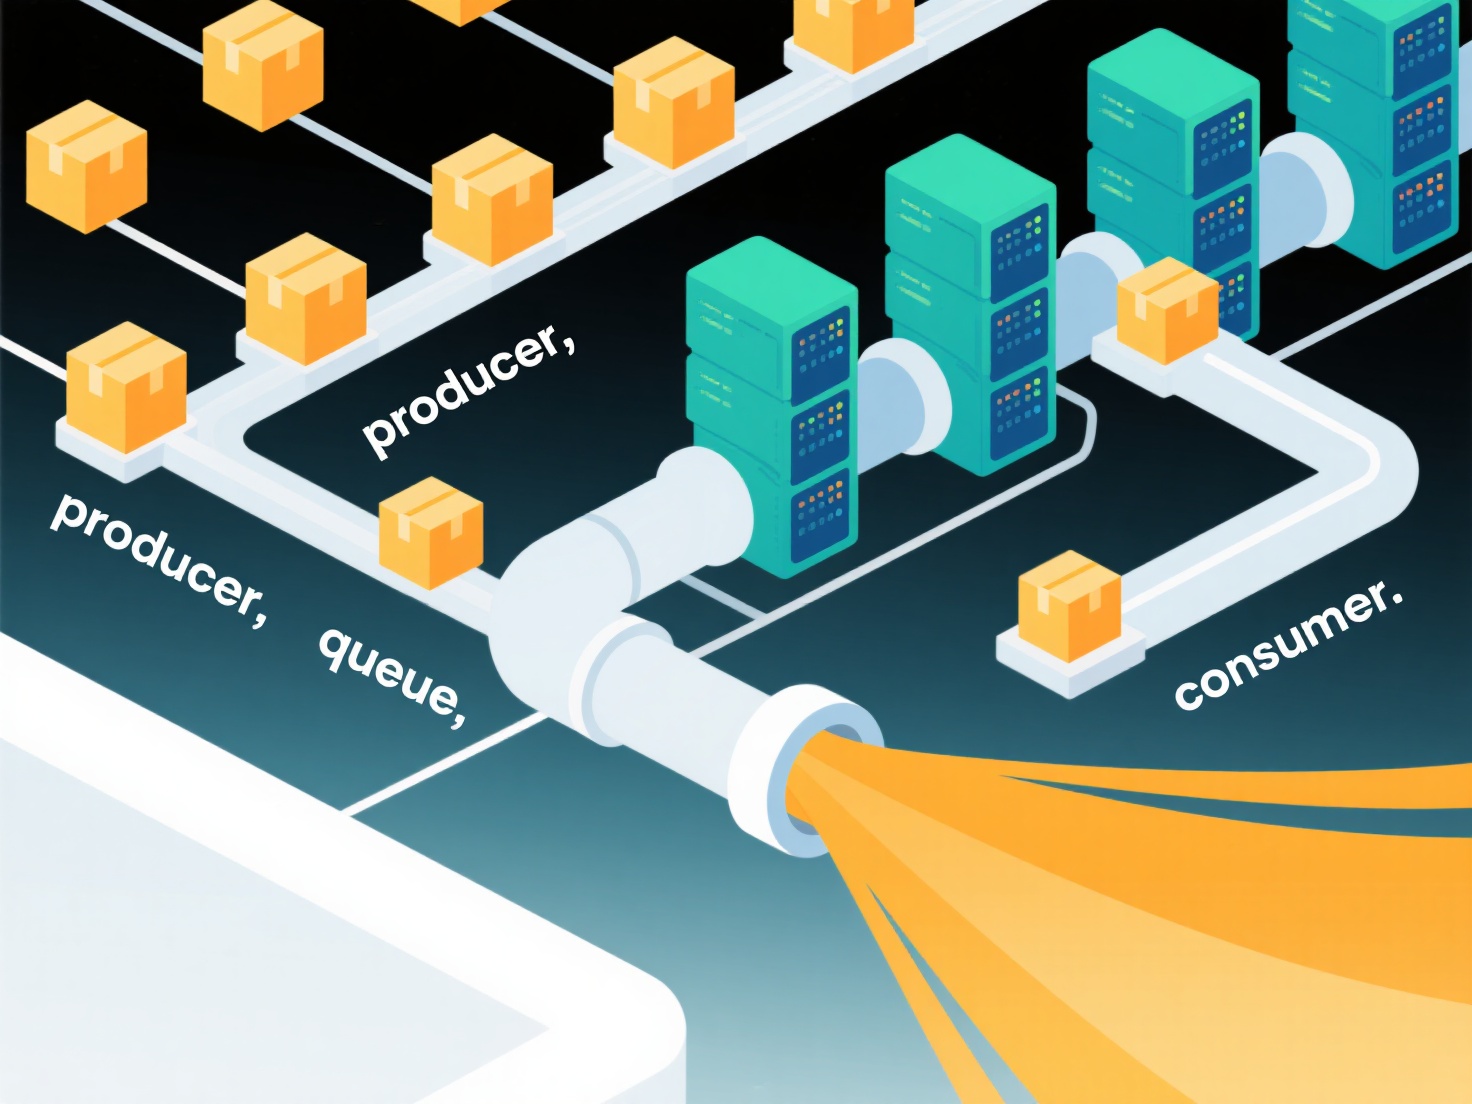
自动化数据管道和工作流是用于摄取、转换和交付数据的编码序列,由事件或调度触发。它们的重要性在于用可靠、可重复的流程取代复杂的手动脚本编写和协调工作。关键应用场景包括实时分析、定期批量报告和机器学习模型部署,在这些场景中,及时、一致的数据流至关重要。它们从根本上改变了大数据架构,实现了事件驱动、弹性且可扩展的数据移动,无需持续的人工监督。
核心特性包括强大的调度、依赖管理、错误处理和监控能力。驱动自动化的原则是编排(如Airflow、Prefect、Dagster等工具)、基础设施抽象和声明式定义。这种自动化通过将重点从复杂的移动逻辑转向数据可靠性和可用性,对架构产生深远影响。架构变得更加精简,将摄取(如Kafka)、处理(Spark、Flink)和存储(数据湖仓、数据仓库)无缝集成到托管工作流中,减少了自定义编码。
自动化带来了运营效率的提升、错误的减少和洞察时间的加速。实施过程包括:选择编排工具、定义管道任务(提取、清理、丰富、加载)、设置触发器/调度、制定错误处理策略以及集成监控。典型场景包括用于仪表板的每日ETL或流点击流处理。业务价值体现在更快的决策制定、因减少人工干预而降低的运营成本,以及为下游分析和AI提供增强的数据可靠性。
继续阅读
大规模管理大数据的未来挑战是什么?
随着前所未有的数据量、速度和多样性增长,大规模数据管理面临着日益严峻的挑战。关键挑战包括确保实时处理能力、管理极端的数据异构性、在庞大的分布式系统中保证强大的数据安全和隐私,以及开发经济高效的存储和处理架构。解决这些问题对于在科学研究、个性化医疗、智能城市和实时分析等领域实现大数据的潜力至关重要。 ...
Read Now →人工智能和机器学习将如何影响大数据系统的发展?
人工智能(AI)在机器中模拟人类智能,而机器学习(ML)允许系统从数据中学习,无需显式编程。它们与大数据系统的集成具有变革性,超越了简单的存储和查询,迈向获取预测性洞察和自动化复杂任务。这种融合对于从海量且通常是非结构化的数据源(如文本、图像、传感器数据)中提取价值至关重要。关键应用包括实时分析、智...
Read Now →数据复制如何帮助提高大数据系统的可用性和性能?
数据复制涉及在多个分布式节点或站点创建和维护数据副本。在处理海量数据的大数据系统中,此过程显著增强了服务连续性和用户可访问性。其重要性在于减轻故障影响和扩展读取操作,这对于全球电子商务平台或实时分析等大规模、始终在线的应用至关重要。 核心机制是在地理上分散的服务器或集群之间复制数据子集。这种冗余使...
Read Now →

